個人開発のバックエンド構成:Cloudflare Workers、Supabase、Node.jsの選び方
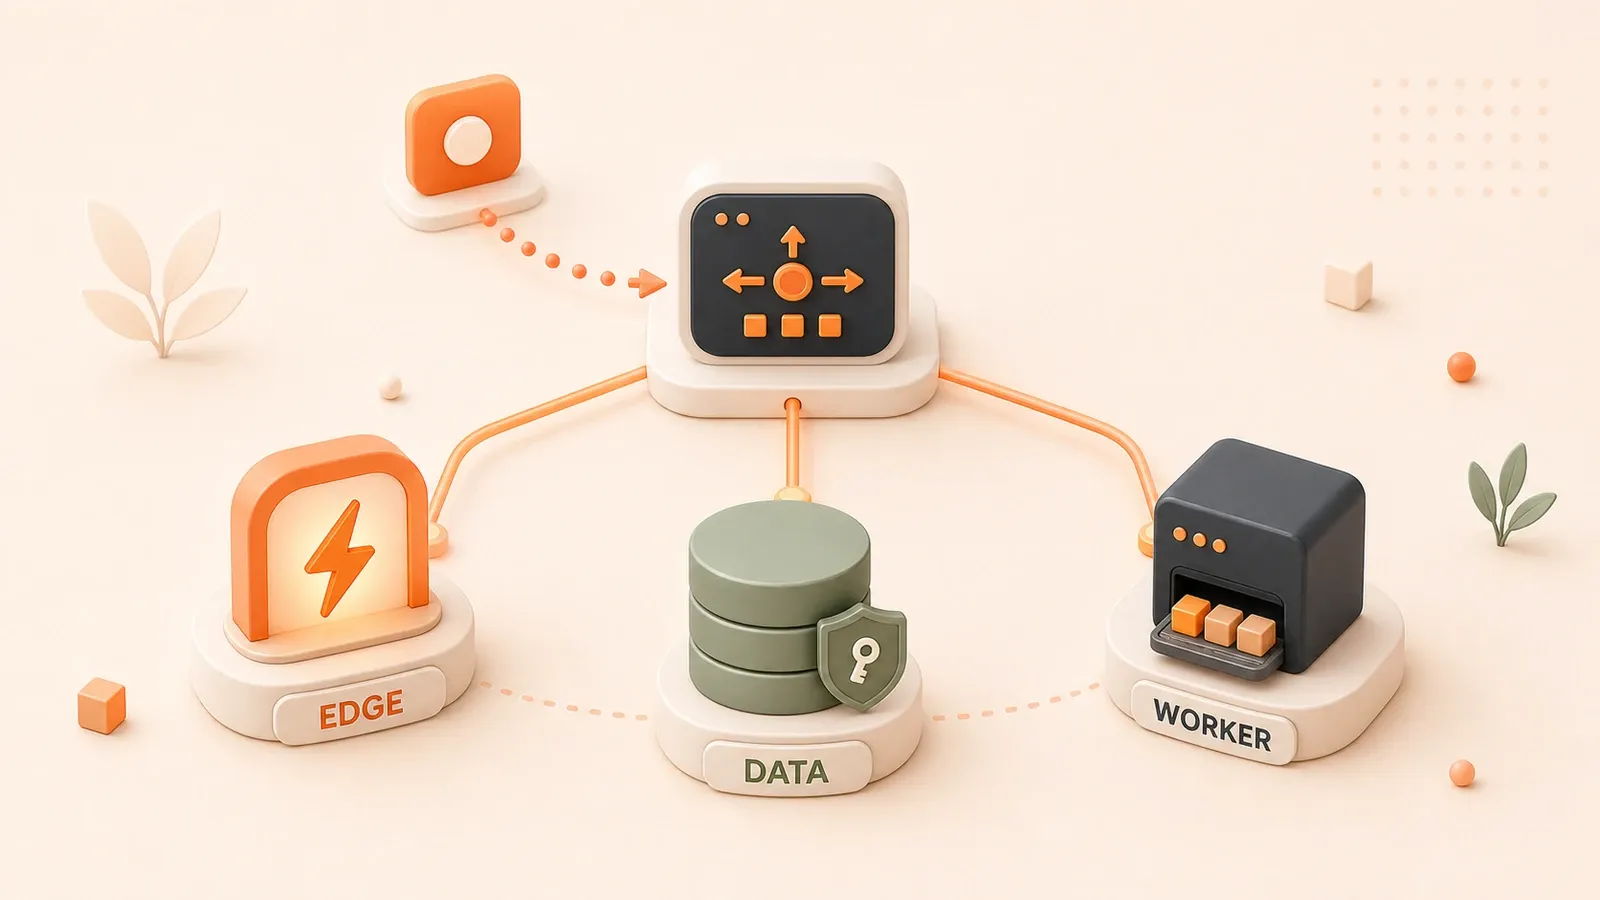
"CloudflareはWorkers FreeとPaidについてrequest、CPU、memory、subrequest、script sizeの上限を分けて公開し、client接続中のHTTP requestには固定のwall-clock上限がないと説明しています。"
ツールのフロントエンドが完成した後、/api/submit、/api/checkout-webhook、/api/report-cronを実装し、users、usage_events、filesも保存する必要があります。どれをWorkersへ置き、どれをSupabaseへ任せ、どの処理に独立したNodeサービスが必要でしょうか。
バックエンド技術スタックは、1つのplatformを選べば終わるものではありません。request入口、業務データ、file storage、長時間処理、認証、Webhookを別々のserviceへ分けます。Workersはedge入口と軽い処理、SupabaseはAuthとPostgres、Node.jsはedge runtimeに収まらない重い処理と依存関係を担当します。次の表を自分のtask一覧と照らし合わせてください。
1. バックエンドの役割分担表:何をどこへ置くか
まずAPI、Webhook、Cron、データ、ファイルの一覧を確認します。
| 役割 | 推奨する配置先 | 判断理由 | 注意点 |
|---|---|---|---|
| request入口 | Cloudflare Workers | edge入口、global配信、低latency | CPU、memory、dependencyの上限を超える処理は分離する |
| 軽いAPI | Workers / Supabase Edge Functions | forward、validation、短いI/O中心の処理 | Workersはedge寄り、Edge FunctionsはSupabase projectと一体 |
| Webhook | WorkersまたはEdge Functions | 外部callback、署名検証、冪等write | 重い処理はcallback内で完了させずqueueへ入れる |
| 認証・user管理 | Supabase Auth | Auth、RLS、権限model、social login | service role keyやsecret keyをbrowserへ公開しない |
| 業務データ | Supabase Postgres | relation、transaction、query、trigger | D1などを選ぶ場合もmigration、constraint、権限が必要 |
| object storage | Supabase Storage / R2 | upload、image、export、backup | file sizeだけでなく権限、egress、CDN、toolingで決める |
| 長時間処理・重い依存関係 | Node.js worker / task platform | browser automation、大きなfile、native module、常駐consumer | 1つの同期HTTP requestにjob全体を結び付けない |
| 従来型Node service | Node.js | 成熟したnpm、長期接続、完全なruntime | deployment、monitoring、patch、scalingを自分で担当する |
この表はバックエンド全体をWorkersへ詰め込むためのものではありません。WorkersにはCPU、memory、subrequestの上限があり、Supabaseにはproject pauseと利用量の境界があります。Node.jsには継続的な運用が伴います。初期はNode serviceを後回しにできますが、導入すべきsignは理解しておきます。
データの配置先を決める
- 業務データ → relation、transaction、query、trigger、foreign keyが必要ならSupabase Postgresまたは別のrelation database。
- ファイル → 権限、egress、CDN、region、既存toolchainでSupabase StorageまたはR2を選ぶ。
- Cache → KV。軽量なedge relation dataにはD1も候補ですが、cacheを業務上のsource of truthにしない。
D1、Postgres、R2、S3、SQLiteの詳しい比較はdatabase・storage選定の記事で扱います。ここではデータ型ごとの配置だけを判断します。
Webhookと長時間処理を分ける
StripeやGitHubのWebhookはWorkersでedge受信するか、Supabase中心のproject内でEdge Functionsに受信させます。handlerは署名を検証し、冪等recordを書き、すぐ応答します。browser automation、大きなfile解析、複数段階の外部待機はQueue、Workflow、Container、Node.js workerへ引き継ぎます。
Workers Paidの通常HTTP requestはCPU上限がdefault 30秒で、最大5分まで設定できます。1時間以上の間隔で実行するCron Triggerは最大15分のCPUを使えます。client接続中のHTTP requestに固定wall-clock上限はありませんが、requestに長時間jobを結び付けるのは安全ではありません。disconnect、retry、resource上限、runtime更新が失敗要因になります。
無料枠の警戒ライン
2026年7月時点で、Workers Freeは1日100,000 request、1 invocation 10 ms CPU、128 MB memory、50 subrequestを含みます。Supabase Freeは50,000 MAU、projectごとに500 MB database、5 GB egress、1 GB file storage、最大2つのactive projectを含みます。
これらは開始時の予算であり、長期のarchitecture保証ではありません。Supabase Freeは1週間利用がないとpauseし、Workers Freeを超えたworkloadはPaidへの移行が必要です。安定userや課金flowができたら、利用量alert、cost表、縮退方法を用意します。
2. Cloudflare Workersに向く処理、向かない処理
Workersは万能なbackendではありません。境界を決めるのはJavaScriptを実行できるかではなく、CPU、memory、subrequest、bundle sizeです。
Workers Freeの上限(2026年7月)
Workers Freeは1日100,000 request、1 invocationあたり10 ms CPUです。memoryは128 MB、subrequestは50、圧縮後Worker sizeは3 MBまでです。CPU超過は1102 errorになります。client接続中のHTTP requestには固定wall-clock上限がなく、response完了またはdisconnect後はctx.waitUntil()で最大30秒延長できます。
Workers Paid Standard planの上限
Workers Paidはaccountあたり月額最低5ドルで、月1,000万requestと3,000万CPU msを含みます。HTTP invocationのCPUはdefault 30秒、最大5分へ設定可能です。追加requestは100万回あたり0.30ドル、追加CPUは100万msあたり0.02ドルです。subrequestは1 invocation 10,000、圧縮bundleは10 MB、memoryは128 MBです。
向いている用途
- request入口、edge proxy、軽いAPI。
- Webhook受信、署名検証、冪等なenqueue。
- Cron、Queues、Workflowsのtriggerとorchestration。
- KV/R2 access、cache header、redirect、A/B routing。
共通点はnetwork I/O、validation、orchestrationが中心であることです。大きなfileやobject graphをmemoryに全展開せず、browser processやnative system libraryも必要としません。
向いていない用途
- 継続的なCPU重処理 → algorithm分割、async化、Node.jsまたはContainerへ移す。
- 大きなfileの全量buffer → stream、object storageへのdirect upload、専用file serviceを使う。
- 長時間browser job → Node.js + Playwright/Puppeteerまたはmanaged browser。
- bundleやruntime互換範囲外のdependency → Node.js serviceまたはcontainer。
WorkersのNode.js compatibility layerは多くのAPIをsupportします。ただしbuildできることと、運用に適することは別です。resource消費、retry、実行時間、observabilityで判断します。
Costの警戒ライン
Workerが平均5 ms CPUを使う場合、月1,000万dynamic requestで約5,000万CPU msです。Workers Paidに含まれる3,000万CPU msを引くと、追加CPU料金は約0.40ドルです。KV、Queues、R2などには別の利用料が発生する場合があります。
金額そのものより重要なのは、中核機能が無料枠内でしか成立しない状態です。超過が利益率や可用性を壊すなら、trafficが増える前にrate limit、cache、fallbackを設計します。
3. Supabase:Auth、Postgres、Storage、Edge Functionsの境界
Supabaseはhosted Postgresだけではありません。Auth、Storage、Realtime、Edge Functionsをまとめていますが、それぞれに上限があります。
Supabase Freeの上限(2026年7月)
Supabase Freeはprojectごとに500 MB database、50,000 MAU、5 GB egress、5 GB cached egress、1 GB file storageを提供します。organizationでは最大2つのactive Free projectを保持できます。1週間利用がないFree projectはpauseするため、検証や低traffic向けであり、production availabilityの保証ではありません。
Supabase Proの枠
Supabase Proは月額25ドルからで、100,000 MAU、projectごとに8 GB disk、250 GB egress、250 GB cached egress、100 GB file storageを含みます。paid planには月10ドル分のcompute creditsも含まれます。追加project、compute、traffic、storage、add-onで料金は増えます。
向いている用途
- 認証とuser:email、OAuth、session、RLSによる権限。
- 業務データ:Postgresのrelation、constraint、transaction、query。
- File storage:access policy付きのuser upload、image、export。
- Postgres trigger、function、database migration。
- Auth、Postgres、Storageと密接に連携するEdge Functions。
user所有dataのwrite、triggerによる関連row更新、upload metadataの保存のように、logicがSupabase Auth、Postgres、Storage中心なら、運用componentを減らせます。
Edge Functionsの上限
Supabase Edge FunctionsはTypeScript/Deno互換runtimeで、Webhook、外部integration、project内APIに向きます。hosted platformの現行上限は256 MB memory、1 requestあたり2秒CPU、request idle timeout 150秒です。workerの最大wall-clockはFree 150秒、Paid 400秒です。
wall-clockにはI/O待ちが含まれ、CPU枠ではありません。browser automation、native multithread library、video処理、大きなfile変換はbackground workerや専用serviceへ移します。background taskも同じCPU、memory、wall-clock上限を受けます。
Edge FunctionsとWorkersの選び方
- Supabase Auth、Postgres、Storageに密接なproject内glue → Edge Functions。
- Supabase依存が弱いedge入口、proxy → Workers。
Stripe Webhookからsubscription tableを更新しSupabase Authを呼ぶならEdge Functionsが直接的です。署名検証、rate limit、forwardだけならWorkersが独立入口になります。どちらでも時間のかかる処理はqueueへ送ります。

Project pauseの動作
Supabase Free projectは1週間利用がないと自動pauseします。たまに使うinternal toolでは次回request時にresumeを待つ場合があります。継続課金productならPro、backup、migration pathを検討します。Freeを長期architecture保証にしないでください。
4. Node.js:従来型サービスが必要になる場面
Serverlessとedge runtimeはserver運用を減らしますが、完全なruntime、system dependency、常駐processの必要性までは消しません。
Node.jsが有効な処理
- PlaywrightやPuppeteerによるbrowser automation。
- 大きなfile処理、複雑なparse、一時diskが必要なtask。
- edge runtimeに入らないnative moduleや成熟したnpm dependency。
- 常駐queue consumer、WebSocket、管理API。
- process model、observability、resource specを統一した共通backend。
web screenshot、PDF生成、data収集、video transcode、大きなfile解析には、より多くのCPU、memory、process、filesystemが必要です。Node.js service、container、専用task platformが向きます。
Node.jsが必要なsign
WorkersやEdge FunctionsのCPU、memory、duration、bundle size、runtime compatibilityへ繰り返し当たる場合、またはbrowser process、native module、長期接続、安定したqueue consumptionが必要ならNode.jsを検討します。
「30秒を超えるか」だけで判断しません。Workers Paid、Cron、Queues、Workflows、Containers、Supabase Functionsはそれぞれ上限が違います。resource、retry、冪等性、observabilityのmodel内でjobが安定して動くかを見ます。
Node.jsが不要な場面
- 単純なAPI forwardやedge routing。
- I/O中心の軽いvalidationとdatabase write。
- 重いfile処理、native dependency、長期接続がない。
- 継続的なserver運用を正当化する需要がまだない。
この段階はWorkersまたはSupabase Edge Functionsで対応でき、独立Node serviceは不要です。
Node.jsは古くない
edge runtimeは制約と引き換えに低運用コストとglobal配信を得ます。完全なNode.js runtimeはinfra運用と引き換えにdependency互換、resource control、常駐processを得ます。新旧ではなく役割が違います。最初はWorkers + Supabaseで軽いAPI、Webhook、認証、業務データを閉じ、browser automationやfile処理が実需要になった時点でNode.js workerを追加できます。
5. Workers + Supabase:API clientとHyperdriveの使い分け
WorkersとSupabaseは競合というより、edge request入口と認証・業務データを組み合わせるstackです。
WorkersとSupabaseを組み合わせる
Workersはforward、validation、rate limit、cacheを担当し、Supabase AuthとPostgresはuser identity、業務データ、権限policyを担当します。軽いqueryと検証後writeが中心で、serverを持ちたくない初期productに向きます。
WorkerからSupabase Auth、Data API、Storageを呼ぶだけならsupabase-jsで十分です。SQL、transaction、ORMでPostgresへ頻繁にaccessするなら、各edge invocationからdirect connectionを作らずdatabase driverとconnection poolを使います。
接続方法の判断表
| 接続方法 | 適する用途 | 説明 |
|---|---|---|
| Supabase JS Client | Auth、Storage、軽いquery、単純操作 | Supabase API経由でJWTとRLSの動作を維持できる |
| Hyperdrive + database driver | 頻繁なSQL、ORM、Postgres direct access | Cloudflareがconnectionをpoolし、適切なread queryをcacheできる |
| service role / secret key | 信頼できるbackendの管理操作 | RLSをbypassできるため、隔離したserver-side clientだけで使う |
HyperdriveはSupabase Postgresへ接続でき、distributed Workersが接続を繰り返すlatencyとconnection pressureを減らします。ただし権限systemではありません。どのdatabase roleで接続し、どのtableへaccessでき、RLSがどう動くかはPostgresのcredentialとpolicyで決まります。
Service role keyの注意点
Supabaseのservice role keyとserver-side secret keyは高権限で、RLSをbypassできます。browser、mobile client、public repository、logへ出さず、信頼できるbackendのsecretとして保存します。
管理操作には専用のserver-side Supabase clientを作り、user sessionがAuthorization headerを上書きしてRLS動作を変えないようにします。Webhook write、batch、admin操作は最小権限とaudit trailを持たせ、高権限keyを全用途に流用しません。
Edge FunctionsとWorkersの責任境界
- Supabase Auth、Postgres、Storageに強く依存 → Edge Functions。
- 独立したedge入口、proxy、rate limit、routing → Workers。
境界は絶対ではありません。dataと権限がSupabase中心か、Cloudflare edge機能が必要か、logとdeploymentをどちらへ集めたいかで決めます。高権限keyはどちらでもbackend secretです。
6. データの帰属:業務データ、ファイル、キャッシュ
D1、Postgres、KV、R2はいずれもデータを保存できますが、解決する問題が異なります。
データ帰属の判断表
| データ型 | 推奨する配置先 | 判断基準 |
|---|---|---|
| 業務上の事実 | Supabase Postgres / D1 / その他relation database | relation、transaction、constraint、query、migration、権限 |
| ファイルobject | Supabase Storage / R2 / S3 | access control、egress、CDN、lifecycle、tooling |
| cacheと設定 | KV / Cache | 低latency read、再構築可能性、許容できるconsistency |
user、order、subscription、project、entitlementは課金やaccessへ影響するため、constraint、migration、backupを持つ業務databaseへ入れます。Postgresは複雑なquery、foreign key、trigger、transactional integrity、MVCCを提供します。D1も軽いrelation dataを保存できますが、consistency、scale、platform上限を別途評価します。
file storageを1 GBのような単一基準で分けないでください。Supabase StorageはAuth/RLSと密接なuser file、R2はCloudflareのtraffic/CDNと連携するobjectに向きます。access policy、egress、upload方法、変換要件、既存SDKで選びます。
cacheはedgeへ置きますが、主業務databaseではありません。KVは設定や再構築可能なread-heavy dataに便利です。orderやentitlementがcacheにしかなければ、expire、sync遅延、誤deleteが実際の業務状態を変えてしまいます。
D1、Postgres、R2、S3、SQLiteの完全比較はdatabase・storage記事で扱います。ここではデータのcategoryだけを割り当てます。
7. シリーズの次のステップ
ここではbackendの役割を分けました。後続ではdeployment、databaseとstorage、payment integration、認証・権限modelを扱います。
関連するBetterLinkの記事
platformの境界を確認するなら、Cloudflare Pagesデプロイガイド、Cloudflare Free Plan Limits 2026、Workers API proxy実践、Supabase入門、Supabase Edge Functions実践へ進めます。
最初に自分の役割分担表を作る
今週公開する5つのbackend処理を挙げ、「即時応答 / 認証・権限 / 業務上の事実 / file / 非同期処理 / 機密情報」を付け、Workers、Supabase、Node.js、または保留へ割り当てます。platformは実装手段です。最初のbackendが安定するかは、責任と失敗経路で決まります。
個人開発の初期バックエンドを役割ごとに割り当てる
ユーザー操作とデータ型を起点に、軽いAPI、認証、業務データ、ファイル、長時間処理を低運用コストのサービスへ割り当てます。
⏱️ 目安時間: 45 分
- 1
ステップ 1: バックエンドの処理を列挙する
フォーム送信、決済Webhook、履歴表示、定期レポート、ファイルupload、利用イベントなど、今週公開する処理を書き出します。 - 2
ステップ 2: 役割を分類する
各処理を即時応答、認証・権限、業務上の事実、ファイル、非同期処理、機密情報に分類します。 - 3
ステップ 3: 最初の配置先を決める
エッジ入口と軽いAPIはWorkers、Auth・Postgres・StorageはSupabase、重い処理と完全なruntimeはNode.jsに割り当てます。 - 4
ステップ 4: プラットフォームの上限を確認する
CPU、メモリ、実行時間、DB容量、egress、ファイルstorage、project pause条件を確認し、中核処理が上限ぎりぎりにならないようにします。 - 5
ステップ 5: セキュリティと失敗経路を補う
service role keyをbrowserへ出さず、Webhook署名、冪等key、再試行、logを用意します。
FAQ
Cloudflare Workersの無料枠で個人開発を始められますか?
Workersだけでバックエンド全体を作れますか?
SupabaseとCloudflare Workersは競合しますか?
WebhookはWorkersとSupabase Edge Functionsのどちらに置きますか?
Node.jsのAPIサービスはもう古いですか?
8分で読めます · 公開日: 2026年10月9日

一人会社テックスタック実践ガイド: Build, automate, ship, grow
検索からこのページに来た場合は、前後の記事もあわせて読むと同じテーマの理解がかなり早く深まります。
前の記事
一人会社のフロントエンド構成:Astro、Next.js、React、Tailwind、shadcn/uiの選び方
コンテンツサイト、ツール、SaaS管理画面ごとにAstro、Next.js、React、Tailwind、shadcn/uiを使い分ける基準と、保守境界や移行の兆候を整理します。
第 5 / 8 記事
次の記事
個人開発のデプロイ先比較:Cloudflare、Vercel、Railwayの選び方
静的サイト、軽量API、Next.jsアプリ、長時間ジョブに分けて、Cloudflare PagesとWorkers、Vercel、Railwayの制限、料金リスク、運用負荷を比較します。
第 7 / 8 記事


コメント
GitHubアカウントでログインしてコメントできます