一人開発のデータベース選び:D1・Postgres・R2・S3・SQLite
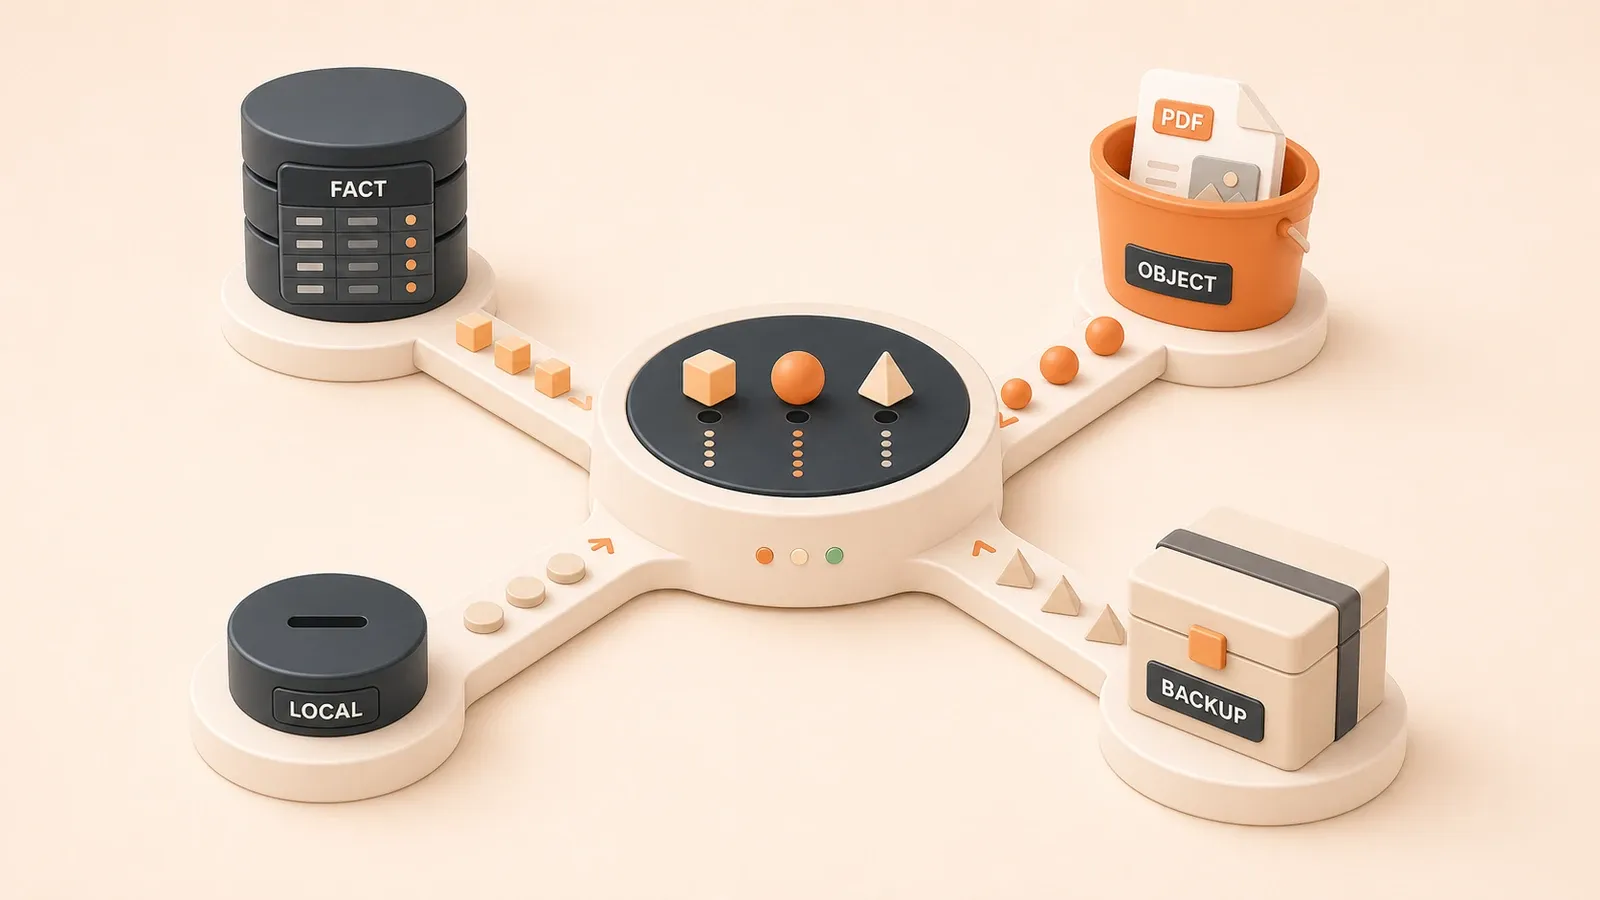
"CloudflareのD1料金ページはrows read/written、保存容量、インデックスが走査行数に与える影響、Freeの日次上限到達時の挙動を説明しています。"
プロジェクトにはusersテーブル、orders、usage_events、ユーザーがアップロードしたuploads/2026/06/report.pdf、cache:daily-stats、ローカル開発用のlocal-dev.sqliteがあります。それぞれをどこに置くべきでしょうか。業務上の事実をオブジェクトストレージに入れると、バックアップ、検索、エクスポートがすぐ扱いにくくなります。D1で絞り込み列にインデックスを付けなければrows readが無料枠を急速に消費し、Paidでは超過料金も発生します。まずデータの種類から考えます。
データ配置表:何をどこに保存するか
一人開発でも、データの性質によって保存先は変わります。業務上の事実には検索、関連、権限制御が必要です。イベントログは安定した書き込みと保管コストが重要です。オブジェクトファイルにはダウンロード権限、ライフサイクル、トラフィックに合う料金体系が要ります。構造化検索と権限が必要か、アクセス頻度はどれくらいか、転送料に敏感かを確認します。
次の表を最初の判断に使えます。
7種類のデータと保存先
| データの種類 | 具体例 | 推奨する保存先 | 判断基準 |
|---|---|---|---|
| 業務上の事実 | users、orders、契約権利、決済記録 | Supabase Postgresを優先、単純な場合はD1 | 構造化クエリ(SELECT/JOIN)、権限(RLS)、プランに合うバックアップ/時点復元、監査性 |
| イベントログ | usage_events、操作記録、アクセス統計 | エッジ書き込みならD1、監査用途ならPostgres | 高頻度書き込みと単純な検索。通常の分析イベントは復旧優先度を下げられるが、セキュリティ/課金イベントは確実に保管 |
| オブジェクトファイル | uploads/2026/06/report.pdf、生成物、エクスポート、画像 | CloudflareならR2、AWSならS3、またはSupabase Storage | DB blobにしない。R2の転送、S3のエコシステム、Supabase Auth/Postgres連携で選択 |
| キャッシュ | cache:daily-stats、短期状態、一時計算 | Cloudflare KV、D1、ローカルSQLite | 高頻度アクセスで通常は期限切れ/再生成が可能。エッジはKV/D1、ローカルはSQLite |
| ローカル開発データ | local-dev.sqlite、テストデータ、単一ユーザー管理画面 | SQLiteファイル | 単一ユーザー、権限システムなし、コピーして実行しやすい |
| 軽量なエッジデータ | Workersのカウンター、設定表、ドメイン対応 | D1またはCloudflare KV | Workersネイティブ、軽い関係、読み取り中心 |
| バックアップ | DB dump、エクスポートスナップショット | R2/S3とローカルコピー | R2の転送料、S3のガバナンス/ライフサイクル、障害に備える別コピー |
業務上の事実をPostgresから始める理由
ユーザー、注文、契約権利、決済はプロジェクトの中核です。失うと顧客の利用権や売上に影響します。必要なのは次の機能です。
- 構造化クエリ:関係データベースはSELECT、JOIN、WHERE、ORDER BYを扱えます。オブジェクトストレージは扱えません。
- 権限制御:Supabase PostgresはRow Level Securityでクライアント向けアクセスを制御できます。D1には現在ネイティブRLSがありません。
- バックアップと復元:Supabase Pro、Team、Enterpriseには日次バックアップがあります。PITRは別途有効化する有料アドオンです。D1 Time TravelはWorkers Freeで7日、Paidで30日保持します。
- 監査:決済や権利の変更は、Postgresのtriggerと監査テーブルで実装しやすくなります。
Supabase Postgresは制限版の抽象層ではありません。各projectには完全なPostgres databaseがあり、Auth、Storage、Realtime、Edge Functionsがその周囲に構築されています(Supabase Database公式ドキュメント)。通常のPostgres機能を利用できます。
イベントと業務レコードを分ける
usage_events、操作、アクセス統計は業務上の事実と性質が異なります。
- 書き込み頻度は高い一方、代表的なクエリは期間指定と集計です。
- 監査対象ではない分析イベントは復旧優先度を下げられますが、保持期間と損失許容度を明示します。セキュリティ、課金、権利イベントは通常のpage viewと同じに扱えません。
- 高頻度書き込みはrows writtenとstorage quotaを消費するため、コストが重要です。
境界は次の通りです。
user_idとactionを結び付ける監査記録ならPostgresを使います。- page view countのようなカウンターや再生成可能な分析信号ならD1またはKVを使えます。
オブジェクトファイルをDBに入れない
アップロード、生成結果、エクスポート、画像をDBのblob列に入れるべきではありません。
- バックアップ費用:すべてのblobがDBバックアップに入り、時間と容量が増えます。
- クエリ負荷:大きなオブジェクトと関係行を混ぜると、転送、cache、backup、保守が重くなり、幅広いクエリが誤ってファイル本体を返しやすくなります。
- CDN配信:オブジェクトストレージはCDN、cache policy、署名付きdownloadに接続しやすい一方、DB blobは通常application proxyを要します。
- 転送料:DB blobの配信はDBとapplicationの帯域を使います。R2から直接Internetへ転送する場合、R2 egress料金はありません。S3はregionとdestinationで変わります。
DBにはuploads/2026/06/report.pdfのようなobject keyだけを保存し、ファイル本体をR2、S3、Supabase Storageに置きます。
キャッシュとローカル開発データ
cache:daily-stats、短期状態、一時計算には次の特徴があります。
- 読み書きが多く、通常は期限切れまたは再生成が可能です。セキュリティに関わるsessionは整合性、期限、失効を別に定義します。
- 再生成可能なcacheは通常、業務DBのbackupに含めません。sessionの失効記録などは独自の永続化方針が必要です。
- エッジではlatencyが重要です。
選択肢は次の通りです。
- Workersの軽量エッジcacheにはCloudflare KVまたはD1を使います。
- ローカル開発にはSQLiteファイルまたはmemory cacheを使います。
local-dev.sqliteは単一ユーザーで権限システムのない用途です。
- SQLiteはlocal application dataとapplication file向けです(SQLiteを使う場面)。
- client/server databaseと同じ問題を解くものではありません。SQLiteはlocal/single-user、Postgresはshared/multi-userを重視します。
軽量なエッジデータとバックアップ
Workersのカウンター、小さな設定表、ドメイン対応にはD1またはKVが出発点になります。
- ネイティブアクセス:Worker bindingまたはHTTP APIを使い、別のconnection poolを運用しません。
- 軽い関係:複雑なJOINや大きなforeign-key graphに依存しない単純なschemaです。
- 読み取り中心:readが多く、writeは比較的少ない用途です。
バックアップのエクスポートには低コストな取り出しと独立したコピーが必要です。
- R2から直接Internetへdownloadする場合、R2 egress料金はありません。
- S3にはObject Lock、複数のarchive class、lifecycle managementがあります。
- account/provider障害に備え、localまたは別providerにもコピーします。本番と同じ場所だけに復元データを置くのは不十分です。
D1:Workersネイティブのserverless database
D1はSQLite SQL semanticsを持つCloudflareのmanaged serverless databaseです(D1概要)。主な機能は次の通りです。
- Time Travel:Workers Freeは過去7日、Paidは30日の任意の1分へ復元できます。復元はDBをその場で上書きするため、時刻を確認します。
- Read replication:読み取りlatencyを下げ、read-heavy workloadのthroughputを拡張します。
- Workers/HTTP API:別のDB connection poolを運用せず、bindingまたはHTTP APIから使えます。
- Built-in disaster recovery:DB historyとrecovery systemをCloudflareが管理します。
適する用途:Workersネイティブで読み取り中心
D1が合うのは次の用途です。

- Workers/Pages上のprojectで、queryのたびに別platformへ接続したくない場合。
- 設定、counter、domain mappingなど、複雑な関係が少ない軽量relational data。
- read replicationで読み取りを拡張できるread-heavy workload。
- Workers、R2、KV、Vectorizeをすでに利用し、同じecosystemにrelational layerが必要な場合。
適しにくい用途は次の通りです。
- 成熟したpermission systemとRLSが必要なmulti-user SaaS。
- 制約、監査、検証済みの復元が必要な注文と契約権利。通常はPostgresが安全な出発点ですが、復元期間はmanaged planとadd-onで変わります。
- Postgresのtrigger/監査patternが必要なaudit-heavy system。
rows read課金:返却行ではなく走査行
D1はrows read、rows written、storageで課金します。rows readは返却行数ではなくqueryが走査した行数です。
2026年7月時点の公式料金ページは次の枠と料金を示しています。公開前や大きな設計判断の前に再確認してください。
| 項目 | Workers Free | Workers Paid |
|---|---|---|
| Rows read | 5M/day | 最初の25B/monthを含む |
| Rows written | 100K/day | 最初の50M/monthを含む |
| Storage | 合計5 GB | 最初の5 GBを含み、超過は$0.75/GB-month |
| Rows read超過 | 利用不可 | $0.001/million rows read |
| Rows written超過 | 利用不可 | $1/million rows written |
| Egress/bandwidth | 追加料金なし | 追加料金なし |
50,000行のordersにSELECT * FROM orders WHERE user_id = ? LIMIT 20を実行し、user_idにindexがなければ、20行を返すためにtableの大部分を走査する可能性があります。rows readは20ではなく50,000に近づきます。
返却件数が少なくても、indexのないfilterはtable全体を走査します。結果件数から推測せず、実際のqueryが返すmeta.rows_readを確認します。
インデックス設計とクエリ効率
rows readを抑える手順です。
CREATE INDEX idx_user_id ON orders(user_id);のようなindexを作り、対象subsetだけを走査させます。値はmeta.rows_readで確認します。- 必要なcolumnだけを取得してresponse payloadと結合を減らします。ただしD1はcolumn数ではなく走査行数を数えます。rows readを減らす鍵はindexとfilterです。
rows_readと返却行を比べます。querymetaとdashboardにrows read/writtenがあるため、効率を計算してfull-table scanを見つけられます。
index設計の要点です。
user_idやcreated_atなどWHEREで使うcolumnにindexを付けます。order_idやproduct_idなどJOIN keyにindexを付けます。- 不要なindexは避けます。INSERT/UPDATEでindex rowも書き込む場合があります。
- D1 dashboardでrows readが異常に多いqueryを定期確認します。
D1無料枠とアップグレードの兆候
Workers Freeの現在の上限です。
- 1日5M rows read。平均50K rows readのqueryは日次上限まで約100回です。
- 1日100K rows written。write-heavy workloadは早く消費します。
- account合計5 GB storageです。
Workers Paidを検討する兆候です。
- 日次rows readが5Mに近づく。Freeは上限後にqueryが失敗し、Paidは月25Bを含み超過課金です。
- 日次rows writtenが100Kに近づく。Paidは月50Mを含みます。
- storageが5 GBを超える。Paid超過は$0.75/GB-monthです。
D1はWorkersに近い軽量relational data向けであり、高頻度writeや大容量storageすべての既定値ではありません。成長に合わせてrows read、rows written、storageを監視します。
Supabase Postgres:BaaSの実用的な既定値
各Supabase projectには制限版ではない完全なPostgres databaseがあります(Supabase Database公式ドキュメント)。Auth、Storage、Realtime、Edge Functionsが周囲に構築され、複雑なquery、foreign key、trigger、transaction、MVCC、extensionを利用できます。
RLSでクライアントアクセスを制御する
Row Level SecurityはSupabase Postgresの大きな利点です。従来はDBをserverだけに公開し、clientはAPI経由でqueryします。RLSはpolicyとkeyを正しく設定すれば、client queryに行単位の権限を適用できます。
RLSが担うことは次の通りです。
- Access control:認証userと
user_idが一致するrowだけ見せるpolicyを定義できます。 - Audit design:RLSはaccess boundaryを定義します。誰がいつ何をしたかは、audit table、trigger、logging systemで別に記録します。
- 重複する権限codeの削減:policyをDBに置けますが、serverはidentity検証、privileged key保護、高権限操作のreviewを続けます。
業務上の事実、権限が重要なapplication、multi-user SaaS、注文、契約権利に向きます。RLSはDBレベルの境界であり、schemaやaudit設計の代わりではありません。
バックアップと復元
2026年7月時点のSupabase公式プランは次の通りです。
| 項目 | Free | Pro | Team |
|---|---|---|---|
| Database size | projectごとに500 MBを含む | projectごとに8 GB、超過課金 | projectごとに8 GB、超過課金 |
| Price | $0 | $25/month | $599/month |
| Automatic backups | 含まない | 日次、7日保持 | 日次、14日保持 |
| PITR | 含まない | 有料add-on、7日保持は約$100/monthから | 有料add-on、7日保持は約$100/monthから |
ここから三つの実務判断ができます。
- Free projectはplatform backupを復元方針にできません。
supabase db dumpまたはpg_dumpを定期実行し、別拠点に保存します。 - Pro/Teamは日次backupがありますが、前回backup後の変更を最大1日分失う可能性があります。
- PITRはProの標準機能ではありません。少なくともSmall computeが必要で、7/14/28日の保持期間ごとに別料金です。
DB容量だけでupgradeを決めません。注文と権利にはRPO、RTO、復元訓練の頻度を先に決め、日次backupで足りるかPITRが必要か判断します。
D1との比較:権限と復元
| 項目 | D1 | Supabase Postgres |
|---|---|---|
| 位置付け | Workersネイティブserverless database | Managed Postgres BaaS |
| 権限制御 | ネイティブRLSなし | RLSでclient queryを制御 |
| 復元 | Time Travel:Free 7日、Paid 30日 | Pro/Team/Enterpriseは日次backup、PITRは有料add-on |
| 適用先 | Workersの軽量relational data | 業務上の事実、multi-user SaaS、注文、権利 |
| 課金 | rows read/writtenとstorage | database storage、compute、plan usage |
併用もできます。
- D1にread-heavyなedge設定、counter、domain mappingを置きます。
- Supabase Postgresにuser、order、契約権利、決済記録を置きます。
SaaS toolの設定とcounterをD1に、userと権利をPostgresに置く構成です。D1はWorkersに近く、Postgresは成熟した権限、制約、復元手段を提供します。
R2:R2側のegress料金がないオブジェクトストレージ
R2はCloudflareのS3-compatible object storageです。R2、Workers API、S3 API、r2.devからInternetへ直接転送する場合、R2 egress料金はありません(R2料金)。bucketに接続した別のmetered serviceが課金する場合はあります。upload、生成結果、exportに向きますが、egress freeはstorageとoperationまで無料という意味ではありません。
Class A/B Operationsの課金
R2はstorage、Class A operations、Class B operationsで課金します。Infrequent Accessにはretrieval feeもあります。
2026年7月時点の料金です。
| 項目 | Free tier | Standard | Infrequent Access |
|---|---|---|---|
| Storage | 10 GB-month/month | $0.015/GB-month | $0.01/GB-month |
| Class A operations | 1M/month | $4.50/million | $9.00/million |
| Class B operations | 10M/month | $0.36/million | $0.90/million |
| Data retrieval | なし | なし | $0.01/GB |
| Internet egress | Free | Free | Free |
| Minimum storage duration | なし | なし | 30日 |
operationの分類です。
- Class A:高価なgroupで、
PutObject、CopyObject、ListObjects、lifecycle tier transitionなどです。writeとlistが中心です。 - Class B:安価なgroupで、
GetObject、HeadObject、HeadBucketなどです。readが中心です。 - 無料operation:
DeleteObject、DeleteBucket、AbortMultipartUploadです。
R2無料枠の誤解
10 GB-monthは無制限storageではありません。
- Storage:billing periodに保持した容量でありtrafficではありません。超える場合はPaid利用またはcleanupが必要です。
- Class A:月1M operationsですが、batch uploadは早く消費します。
- Class B:月10M operationsで多くのreadを賄えますが、高trafficの画像originは超える可能性があります。
Infrequent Accessは30日のminimum storage durationがあります。早く削除してもminimum chargeは残るため、backupや長期object向けで、一時出力には向きません。
適する用途:アップロードと生成結果
R2が合う用途です。
uploads/2026/06/report.pdf、画像、文書などのuser upload。downloadが多い用途に向きます。- 生成report、export、画像処理結果。
- 低コストで取り出したいDB dumpとsnapshot。
- Workers、D1、KV、Vectorizeを利用するproject。
適さない用途です。
- structured queryとaccess controlが必要なuser/orderなどの業務上の事実。
- S3 Object Lock、より多いstorage tier、AWSネイティブのcross-bucket/cross-region replicationが必要なworkload。
R2とS3の比較
| 項目 | R2 | S3 |
|---|---|---|
| Internet egress | R2側は無料、接続するmetered serviceは課金の場合あり | region、destination、usageで変わるため現行AWS料金表で確認 |
| Storage | Standardは$0.015/GB-month | StandardやGlacierを含む複数tier |
| Ecosystem | Workers/Pagesネイティブ | Lambdaを含む広いAWS連携 |
| Governance | lifecycle、Standard/IA、Queues event notification | Object Lock、複数Glacier class、lifecycle、Replication、複数event destination |
| 適用先 | Cloudflare ecosystem、egress-sensitive delivery | AWS ecosystem、governance、data lake、enterprise application |
R2を選ぶ場面です。
- downloadが多くegress costが重要です。
- applicationがWorkers/Pages上で動きます。
S3を選ぶ場面です。
- Lambda、data lake、enterprise workflowがAWS serviceに依存します。
- Object Lock、より多いGlacier class、cross-region replication、AWSネイティブIAM governanceが必要です。
- CloudWatch、IAM、batch operationなど広いAWS toolchainに価値があります。
R2とS3は完全な代替関係ではありません。Cloudflare上のproductがCDN fileと生成物をR2に置き、governance対象archiveをS3に置く構成も可能です。
S3:AWSエコシステムとガバナンス
Amazon S3はdata lake、website、mobile application、backup/restore、archive、enterprise application、IoT、analyticsに使うobject storage serviceです(Amazon S3 User Guide)。次の機能があります。
- Standard、Intelligent-Tiering、Glacier、Glacier Deep Archiveなどのstorage class。
- objectを自動で移行または削除するlifecycle rule。
- WORM保持で上書き/削除を防ぐObject Lock。
- recovery、latency、governance向けのSame-Region/Cross-Region Replication。
- IAM、bucket policy、Block Public Access。
- LambdaなどAWS destinationへのevent notification。
適する用途:AWS連携とガバナンス要件
S3が合う用途です。
- Lambda、EC2、RDS、DynamoDBをすでに使うproduct。
- Object Lock、archive class、正式なretention controlが必要な場合。
- AWS analytics serviceに依存するdata lake/IoT pipeline。
- lifecycle ruleを使う長期backup、restore、archive。
適しにくい用途です。
- user downloadが多くegress costに敏感な場合。対象region、destination、cache、volumeの現行AWS料金を使って見積もります。
- applicationがCloudflareネイティブで、Workers/PagesからR2へ直接アクセスできる場合。
S3とR2:エコシステムとガバナンスの深さ
S3の主な利点はAWS連携とgovernance機能の幅です。
- Event destination:S3 Event NotificationsはSNS、SQS、Lambda、EventBridgeへ送れます。R2もobject-create/deleteをCloudflare Queuesへ送り、WorkerまたはHTTP pullで処理できます。
- Storage class:S3は複数のGlacier archive classを持ち、R2は現在StandardとInfrequent Accessが中心です。
- Object Lock:保持期間中の上書き/削除をWORMで防止します。
- Replication:同regionまたは別regionのbucketへobject、metadata、tagをcopyできます。
S3を選ぶ場面です。
- Lambda、data lake、enterprise applicationがAWS連携に依存します。
- Object Lock、Glacier class、lifecycle governanceが必要です。
- 長期archiveでGlacier familyが有利です。
R2を選ぶ場面です。
- user uploadと生成fileが頻繁にdownloadされます。
- Workers/Pagesが主要runtimeです。
CDN fileと生成結果をR2に、governance対象backupをS3に置く併用もできます。providerを一つに固定せず、data typeとaccess patternで決めます。
SQLite:ローカルと組み込みを優先する
SQLiteはlocal application data、application file、低〜中traffic site、analysis、cacheに向きます(SQLiteを使う場面)。client/server SQL databaseと直接競合する製品ではありません。client/server systemはshared repository、concurrency、centralization、controlを重視し、SQLiteはlocal/single-userでcopy可能な単一fileを重視します。
適する用途:単一ユーザーツールとローカルbackend
SQLiteが合う用途です。
- single-user tool、local dashboard、analysis utility、小規模game、one-file dataset。
- CAD、finance、media management softwareのapplication file format。
- 低〜中traffic website。SQLite公式は100K hits/day未満なら一般に良好と説明しますが、保守的な目安であり性能保証ではありません。hardware、query complexity、concurrent writeで変わります。
local-dev.sqliteのようなlocal development data。- durable shared stateが不要なcacheとtemporary calculation。
適しにくい用途です。
- permission、concurrent write、auditが必要なmulti-user SaaS。
- 成熟したbackup/point-in-time recoveryが必要なorderとsubscription entitlement。
- SQLiteは多readerを許してもwriterは一つなので、write-heavy concurrency。
SQLiteとPostgres:移行の兆候
| 項目 | SQLite | Postgres |
|---|---|---|
| 位置付け | local data、application file | shared client/server repository |
| 適用先 | single-user tool、小規模game、local dashboard | multi-user SaaS、order、subscription entitlement |
| Concurrency | one writer、many readers | MVCCによるmultiple writers |
| Permission | built-in user managementなし | RLSとuser/role management |
| Cost | 独立DB server不要 | self-host/managed plan、compute、backupで変動 |
SQLiteからPostgresへ移る兆候です。
- single-user toolがmulti-user SaaSになり、permission systemが必要になる。
- 複数userまたはinstanceが同じstateを同時更新する。
- paymentによりorder/entitlementのauditと検証済みrecoveryが必要になる。
users/roles/permissionsmodelにDBレベルのaccess controlが必要になる。
個人用analysis dashboardはSQLiteのままで構いません。複数の有料customerがserviceを共有するなら、Postgresが明確な境界です。
SQLiteはPostgresの代替ではない
SQLite公式もclient/server SQL databaseを置き換えるものではないと説明しています。
- SQLiteはlocal、single-user、単一fileをcopyできるsimplicityを重視します。
- Postgresはshared multi-user repository、concurrent state change、payment-critical recordを重視します。
SQLiteは独立DB serverを必要としません。Postgresのcostはself-host/managed plan、compute、storage、backupで変わります。どちらも検証済みのrestore processが必要です。
SQLiteを選ぶ場面です。

- paymentやpermission systemのないlocal utilityと小規模game。
- development fixtureとtemporary data。
- write concurrencyが低いpersonal siteとdocumentation tool。
Postgresを選ぶ場面です。
- order、subscription、permissionを持つmulti-user SaaS。
- operationとentitlement changeを監査する場合。
- configurable point-in-time recoveryが必要なbusiness record。
併用もできます。local developmentや再生成可能cacheはSQLite、production business factはPostgresに置きます。
避けるべき三つの誤り
代表的な誤りは、業務上の事実をobjectとして保存すること、D1のscan-based billingを無視すること、R2無料枠を無制限と考えることです。復元が難しくなり、queryが遅くなり、costの予測性が下がります。
誤り1:業務上の事実をオブジェクトストレージへ置く
users、orders、監査対象のusage_eventsをR2/S3に置くべきではありません。object storageにはrelational query、constraint、row-level permission、DB audit patternがありません。
具体的な問題です。
- SELECT/JOIN不可:object storageはkey-basedです。
SELECT * FROM orders WHERE user_id = ? LIMIT 20に答えるにはapplicationがorder objectをlist/downloadする必要があります。 - 復元が難しい:file collectionはtransactional order historyではありません。SQL dumpやmanaged point-in-time systemの方が一貫したDB recovery pathになります。
- exportが遅い:DB queryは条件に合うrecordをstreamできますが、object-per-order設計では多くのfileを走査します。
業務上の事実はDB、fileはobject storageへ置きます。DBは安定したobject keyを保存し、R2、S3、Supabase Storageがfileを保持します。
誤り2:rows read課金を見落とす
D1は返却行ではなく走査行を数えます。indexのないfilterはresult countよりはるかに多いrows readを消費します。
50,000行のordersでSELECT * FROM orders WHERE user_id = ? LIMIT 20を実行し、user_idにindexがなければ多数の行を走査します。実際の課金対象はmeta.rows_readで分かります。Freeは日次5M上限後にqueryが失敗し、Paidは月次包含量を超えると課金されます。
対策です。
- 実際のfilter columnに
CREATE INDEX idx_user_id ON orders(user_id);のようなindexを付けます。 EXPLAIN QUERY PLANとmeta.rows_readでfull-table scanが残っていないか確認します。- 必要なcolumnだけ選びpayloadを抑えますが、D1はcolumnではなくrowを数える点を忘れません。
誤り3:R2無料枠を無制限と考える
R2無料枠は現在、Standard storage 10 GB-month、月1M Class A、月10M Class Bです。無制限ではありません。
よくある誤解です。
- 10 GB-monthは期間中のstored capacityで、transfer allowanceではありません。
PutObjectはClass A operationです。総容量が小さくてもbatch作成で枠を消費します。- Infrequent Accessには30日のminimum durationがあり、早く削除してもminimum chargeが発生します。
storageとoperation countを監視し、古いoutputを計画的にexpireし、一時fileにはInfrequent Accessを使いません。短期dataならlocal SQLiteまたはcacheの方が適します。
まとめ
保存先は、業務上の事実、イベント、オブジェクト、キャッシュ、ローカル開発データ、軽量エッジデータ、バックアップという種類で選びます。Supabase Postgresはrelation constraint、RLS、設定可能なrecovery、audit patternを持つため業務データの起点になります。D1はWorkersネイティブの軽量relational data、R2/S3はobject、SQLiteはsingle-user local dataに向きます。
最初のversionを安全にする三つの行動です。
- 各objectを分類し、query、permission、access frequency、cost要件を記録します。
- D1のfilter columnにindexを付け、rows-read metricで結果を検証します。
- business recordをobject storageに置かず、unindexed scanを避け、R2はstorageだけでなく全無料枠を見積もります。
次の記事ではpaymentとuser systemを扱います。payment orderにはPostgresのconstraint、backup、auditが、user entitlementとpermissionにはRLSと検証済みrecoveryが必要です。
保存先がまだ曖昧なら、データ配置表とseries前半のarchitecture principle、backend stack、deploymentの記事へ戻ります。system boundaryを決めてからstorageの役割を細分化してください。
一人開発プロジェクトの保存先を決める
データの棚卸しから復元テストまで、6段階でデータベースとオブジェクトストレージの役割を分けます。
- 1
ステップ 1: データを棚卸しする
users、orders、usage_events、uploads、cache、ローカルファイル、バックアップを製品別に分けず列挙します。 - 2
ステップ 2: データの種類を付ける
各項目を業務上の事実、イベント、ファイル、キャッシュ、ローカルデータ、バックアップに分類し、期限切れや再生成が可能か記録します。 - 3
ステップ 3: 整合性と権限を定義する
トランザクション、制約、RLS、同時書き込み、監査、複数インスタンス共有の要件からPostgresかD1かを判断します。 - 4
ステップ 4: アクセス量と課金要因を見積もる
D1 rows read/written、R2 Class A/B operations、容量、読み取り頻度、出力転送料を見積もります。 - 5
ステップ 5: 安定した参照を設計する
object key、owner、status、metadataはデータベースに、ファイル本体はオブジェクトストレージに置き、keyの命名を安定させます。 - 6
ステップ 6: バックアップと移行を検証する
エクスポート、別拠点コピー、削除猶予、復元訓練を用意し、移行ではmetadata、ファイル、読み取り経路の順に切り替えます。
FAQ
一人開発ではD1とSupabase Postgresのどちらを先に選ぶべきですか?
R2とS3には何を保存しますか?
SQLiteで最初のSaaSを運用できますか?
ユーザーのアップロードをデータベースに保存できますか?
D1のrows read課金とは何ですか?
Cloudflare R2の無料枠で足りますか?
13分で読めます · 公開日: 2026年10月9日

一人会社テックスタック実践ガイド: Build, automate, ship, grow
検索からこのページに来た場合は、前後の記事もあわせて読むと同じテーマの理解がかなり早く深まります。


コメント
GitHubアカウントでログインしてコメントできます